목차7개 항목
출처와 참고
섬 개수 예제는 「LeetCode 200. Number of Islands」 풀이 글로 보강했다.
BFS(Breadth-First Search, 너비 우선 탐색)는 그래프에서 시작 노드와 가까운 노드부터 차례로 탐색하는 알고리즘이다. 물결이 퍼지듯 거리 1인 노드를 모두 본 뒤 거리 2, 거리 3으로 넓혀 가므로, 모든 간선의 비용이 같은 그래프에서 최단 거리를 구할 때 가장 먼저 떠올려야 할 방법이다. 미로 탈출 최단 경로, 감염·전파 범위 계산 등에 쓰인다.
동작 과정
가까운 노드부터 처리하려면 먼저 넣은 것을 먼저 꺼내는 큐(Queue)가 필요하다.
- 시작 노드를 큐에 넣고 방문 처리한다.
- 큐에서 노드를 하나 꺼내, 아직 방문하지 않은 인접 노드를 모두 큐에 넣고 방문 처리한다.
- 큐가 빌 때까지 2를 반복한다.
방문 처리는 같은 노드를 큐에 두 번 넣지 않도록 표시하는 것이다. 꺼낼 때가 아니라 넣을 때 표시해야 중복 삽입이 생기지 않는다.
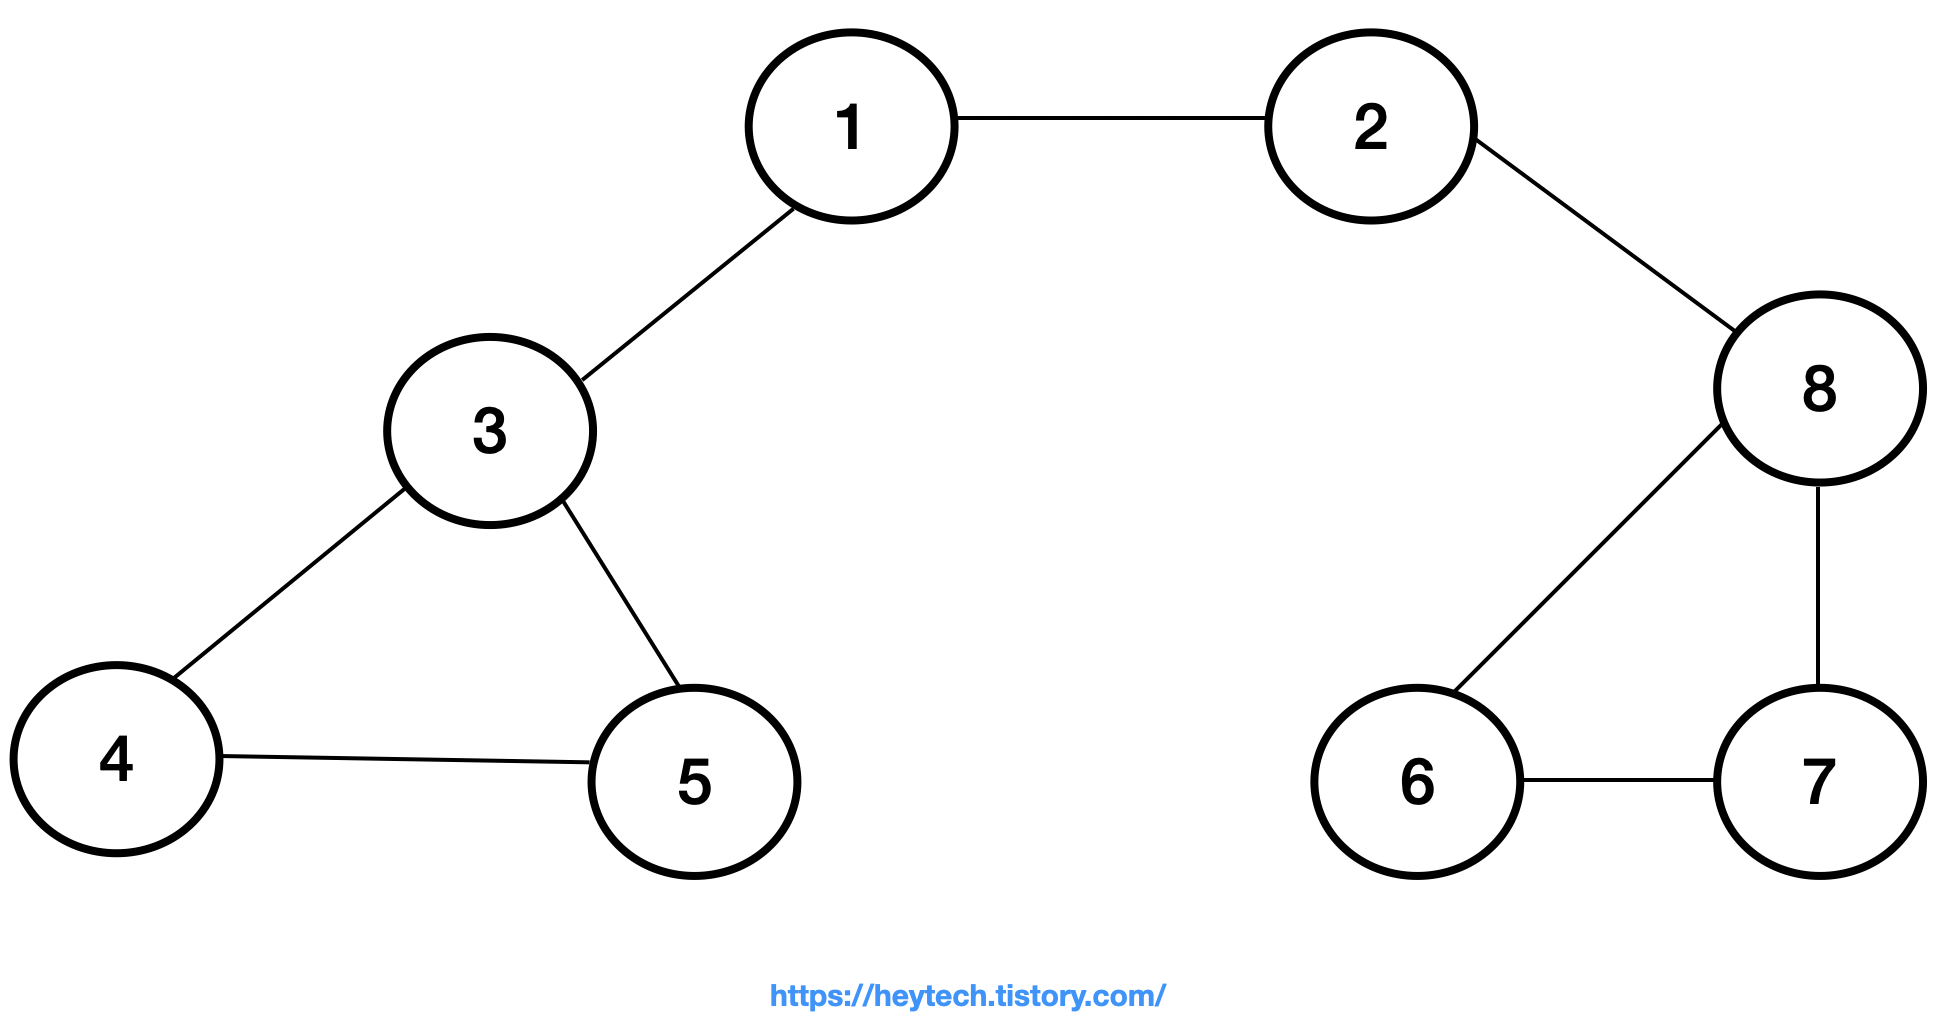
위 그래프에서 노드 1부터 시작하고, 인접 노드가 여러 개면 번호가 작은 것부터 처리한다고 하자.
| 단계 | 큐에서 꺼낸 노드 | 새로 넣은 노드 | 큐 상태 |
|---|---|---|---|
| 시작 | - | 1 | [1] |
| 1 | 1 | 2, 3 | [2, 3] |
| 2 | 2 | 8 | [3, 8] |
| 3 | 3 | 4, 5 | [8, 4, 5] |
| 4 | 8 | 6, 7 | [4, 5, 6, 7] |
| 5~ | 4, 5, 6, 7 | 없음 | [] |
탐색 순서는 1 → 2 → 3 → 8 → 4 → 5 → 6 → 7이다.
기본 구현
from collections import deque

def bfs(graph, start, visited):
    queue = deque([start])
    visited[start] = True
    while queue:
        v = queue.popleft()
        print(v, end=' ')
        for nxt in graph[v]:
            if not visited[nxt]:
                visited[nxt] = True
                queue.append(nxt)

# 인덱스 = 노드 번호 (0번은 비워 둔다)
graph = [
    [],
    [2, 3],
    [1, 8],
    [1, 4, 5],
    [3, 5],
    [3, 4],
    [7, 8],
    [6, 8],
    [2, 6, 7],
]
visited = [False] * 9
bfs(graph, 1, visited)  # 1 2 3 8 4 5 6 7
큐는 반드시
collections.deque를 쓴다.list.pop(0)은 꺼낼 때마다 나머지 원소를 앞으로 당기느라 O(n)이 걸려, 노드가 많으면 전체가 O(V²)로 느려진다.
노드 V개, 간선 E개일 때 인접 리스트 기준 시간 복잡도는 O(V + E)다. 메모리는 큐에 한 "층(level)"의 노드가 한꺼번에 들어가므로 그래프의 너비에 비례한다.
격자(미로) BFS 패턴
방문 여부 대신 거리를 기록하면 바로 최단 거리 표가 된다. 다음 칸의 거리 = 현재 칸의 거리 + 1이다.
코딩 테스트에서 가장 흔한 형태는 N×M 격자에서 상하좌우로 이동하는 문제다. 좌표를 노드로, 인접한 칸을 간선으로 본다. 미로(0 통로, 1 벽)에서 출발 칸부터 도착 칸까지 지나야 하는 최소 칸 수를 구하는 문제로 핵심 루프를 보자.
from collections import deque

def shortest_cells(board, n, start, goal):
    dist = [[-1] * n for _ in range(n)]      # -1 = 미방문, 그 외 = 출발점에서의 거리
    dist[start[0]][start[1]] = 0
    queue = deque([start])
    while queue:
        ci, cj = queue.popleft()
        if (ci, cj) == goal:
            return dist[ci][cj] - 1          # 출발·도착 칸을 뺀 '지나는 칸' 수
        for di, dj in ((-1, 0), (1, 0), (0, -1), (0, 1)):
            ni, nj = ci + di, cj + dj
            if 0 <= ni < n and 0 <= nj < n and dist[ni][nj] == -1 and board[ni][nj] != '1':
                dist[ni][nj] = dist[ci][cj] + 1
                queue.append((ni, nj))
return 0 # 도달 불가dist배열 하나가 방문 표시와 거리 기록을 겸한다. 통과 조건은 아직 방문하지 않은 칸(dist == -1)이다. 실수로 "이미 방문한 칸만 통과"로 쓰면 탐색이 한 발도 나가지 못한다.- 방향 배열
(di, dj), 범위 검사, 벽 검사, 방문 검사 네 가지를 한 조건문에 묶는 것이 격자 BFS의 기본형이다.
상황별 변형 포인트
같은 루프를 두고 문제가 묻는 것에 따라 어디를 바꾸는지만 알면 된다.
| 상황 | BFS 변형 포인트 |
|---|---|
| 가장 늦게 도달하는 노드 찾기 (동시에 퍼지는 연락망·전염) | 거리 = 도달 "시각"이다. 큐에서 꺼낼 때마다 (dist, 번호)를 비교해 최댓값을 갱신한다. 방향 그래프의 중복 간선은 set으로 걸러 둔다 |
| 정해진 시간(단계) 안에 도달 가능한 칸 세기 | 거리가 한도에 닿은 칸은 꺼낸 뒤 확장하지 않고 continue한다. 칸마다 열린 방향이 다르면 현재 칸이 그 방향으로 열려 있고 다음 칸도 반대 방향으로 열려 있는지 둘 다 확인한다 |
| 연결 요소마다 따로 계산 (값 차이가 1인 칸들의 묶음 크기 등) | 전체 칸을 순회하며 미방문 칸을 만날 때마다 BFS를 새로 시작한다. 한 번의 BFS가 끝나면 그 묶음의 크기·최솟값을 모아 최선값과 비교한다 |
연결 요소 세기: 섬 개수
「Number of Islands」(LeetCode 200)는 '1'(땅)·'0'(물) 격자에서 상하좌우로 이어진 땅 묶음의 개수를 센다. 대각선은 이어지지 않는다. 모든 칸을 훑다가 아직 방문하지 않은 땅을 만나면 그 칸에서 BFS를 시작해 섬 전체를 방문 처리하고 개수를 1 올린다. 시간은 O(mn), 큐는 최악에 O(mn)이다.
from collections import deque

def num_islands(grid):
    m, n = len(grid), len(grid[0])
    count = 0
    for x in range(m):
        for y in range(n):
            if grid[x][y] != '1':
                continue
            count += 1
            grid[x][y] = '0'                      # 넣을 때 방문 처리
            queue = deque([(x, y)])
            while queue:
                cx, cy = queue.popleft()
                for dx, dy in ((-1, 0), (1, 0), (0, -1), (0, 1)):
                    nx, ny = cx + dx, cy + dy
                    if 0 <= nx < m and 0 <= ny < n and grid[nx][ny] == '1':
                        grid[nx][ny] = '0'
                        queue.append((nx, ny))
return count| 함정 | 결과 | 대응 |
|---|---|---|
| 꺼낼 때 방문 처리 | 같은 칸이 여러 번 큐에 들어간다. 300×300 전부 땅이면 넣는 횟수가 약 두 배(9만 → 18만)가 된다 | 큐에 넣는 순간 방문 처리한다 |
입력 격자를 '0'으로 덮어쓰기 | 방문 배열이 필요 없지만 호출한 쪽의 원본이 사라진다 | 원본을 지켜야 하면 별도 visited 배열(O(mn))을 쓴다 |
| 재귀 DFS | 섬 하나가 9만 칸이면 Python RecursionError, Node RangeError, Java StackOverflowError | BFS나 명시적 스택 DFS로 바꾼다 |
정수 1과 비교 | 칸 값이 문자 '1'이라 조건이 늘 거짓이 되어 0을 돌려준다 | 입력 타입을 먼저 확인한다 |
| 아래쪽 범위 검사 누락 | Python은 음수 인덱스가 반대편 끝을 가리켜 오류 없이 틀린 칸을 읽는다 | 0 <= 검사를 격자를 읽기 전에 둔다 |
BFS와 DFS, 언제 무엇을 쓸까
| 상황 | 선택 |
|---|---|
| 가중치 없는 그래프의 최단 거리·최소 횟수 | BFS (처음 도달한 순간이 최단) |
| 레벨(시간) 단위로 퍼지는 시뮬레이션 | BFS |
| 모든 경로·조합을 다 봐야 하는 문제, 백트래킹 | DFS |
| 연결 요소 개수 세기 | 둘 다 가능 |
BFS는 한 레벨의 노드를 모두 큐에 담으므로 그래프가 넓을수록 메모리를 많이 쓰고, DFS는 현재 경로만 스택에 담으므로 깊이에 비례한다. 트리에서 BFS는 레벨 순회(level order)와 같다.
핵심 정리
- BFS = 큐 + 넣을 때 방문 처리, 시간 복잡도 O(V + E)
- 가중치가 모두 같으면 BFS가 곧 최단 거리 알고리즘이다. (가중치가 다르면 다익스트라)
- 격자 문제는 방향 배열
(di, dj), 범위 검사, 방문(거리) 배열을 세트로 기억해 둔다. - 연결 요소 세기는 전체 칸을 훑으며 미방문 칸마다 BFS를 새로 시작한다. 큰 격자에서는 재귀 DFS 대신 BFS나 명시적 스택을 쓴다.
관련 노트: 큐와 덱, DFS, 다익스트라, 그래프의 기본, 웹 검색엔진의 동작: 크롤링, 색인, 랭킹, 질의 처리